
基本スペック
| 項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| 公開日 | 2026年9月22日 | — |
| モデルID | claude-opus-5-5 | claude-opus-5 |
| 入力 100万トークン | 4ドル | 5ドル |
| 出力 100万トークン | 20ドル | 25ドル |
| バッチ処理 | 50%引き | 50%引き |
| キャッシュ読み込み | 0.20ドル | — |
| コンテキスト | 100万トークン | 100万トークン |
| 最大出力 | 12万8千トークン | 12万8千トークン |
| 既定の | medium | high |
| 知識の | 2026年6月 | — |
| 提供終了の | 2027年9月22日以降 | — |
公式は
提供先は
何が
Claude Opus 5 から
- 価格が
下がった :入力4ドル/出力20ドル。 バッチ処理は 半額、 キャッシュ読み込みは 0.20ドル - 既定の
effort が medium に なった :指定しなければ、 以前より 浅く 考えて 速く 返る - 出力が
3割速くなった :同じ 内容を 返すまでの 時間が 短い - 入出力トークンが
2割減った :同じ 仕事を、より 少ない トークンで 終える - 思考を
オフに できなくなった :無効化すると エラーに なる。 深さの 調整は effort で 行う - ツールの
強制呼び出しが 使えなくなった :tool_choice の any と tool は エラーに なる - チャートや
図の 読み取りが 上がった :密な 図から 値を 読むのに、 画像ツールを 補助に 使う 必要が 減った
公式が
ベンチマークは
まず、
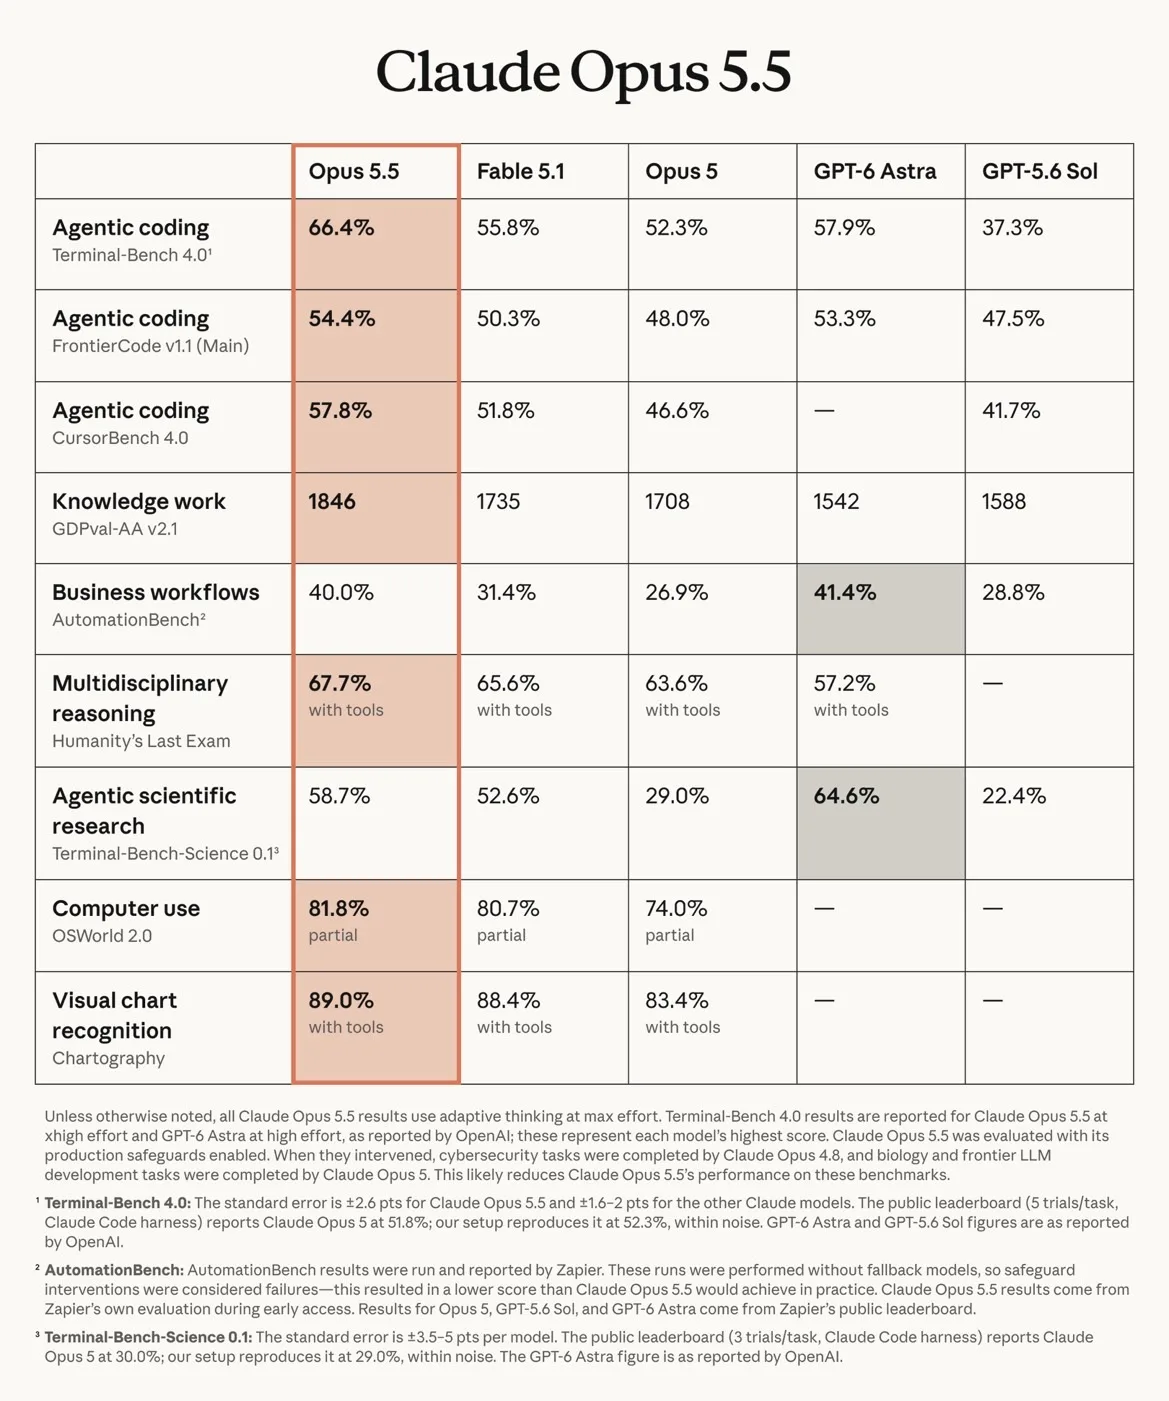
9項目のうち7項目で
一方、
ここで
- 標準誤差が
ある :Terminal-Bench 4.0 は Opus 5.5 で ±2.6ポイント、 他の Claude モデルで ±1.6〜2ポイント。 1〜2ポイントの 差は 誤差に 埋もれる - 安全機構が
作動した分、 スコアが 下がっている :介入が 起きた 課題は 旧モデルが 代わりに 解いており、 公式は 「Opus 5.5 の スコアを 下げていると 考えられる」と 明記している - 条件が
揃っていない 項目が ある :AutomationBench は Zapier に よる 測定で、 代替モデルなしで 走らせた ため、 安全機構の 介入が そのまま 失敗と して 数えられている - effort の
水準が 違う :Terminal-Bench 4.0 は Opus 5.5 が xhigh、 GPT-6 Astra が high での 結果。 それぞれの 最高点どうしを 並べている
つまり
同じ
こちらは
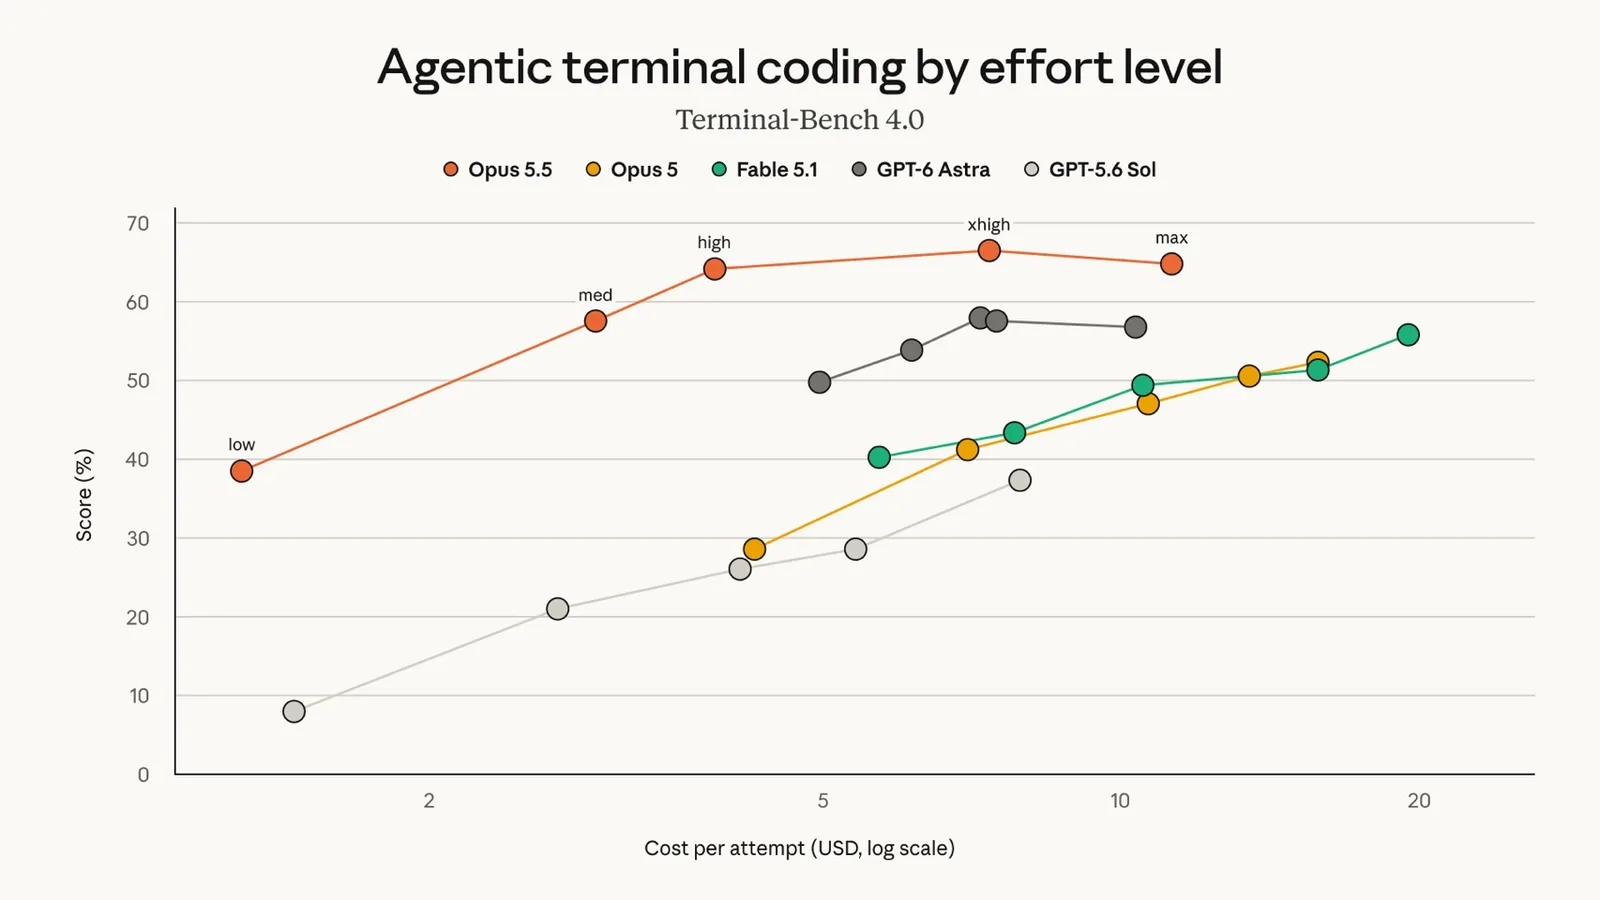
Opus 5.5 の
| effort | コスト | スコア |
|---|---|---|
| low | 約1.3ドル | 38.5% |
| medium | 約3ドル | 57.7% |
| high | 約4ドル | 64.2% |
| xhigh | 約7.5ドル | 66.4% |
| max | 約11ドル | 64.8% |
コストは
- low:単純な
作業、 サブエージェント - medium:速度・コスト・性能の
均衡 (既定) - high:複雑な
推論、 難しい コーディング - xhigh:30分を
超える 長時間の エージェント作業 - max:最も
深い 推論が 要る 課題
読み取れる
第一に、
第二に、
第三に、
深く
もう
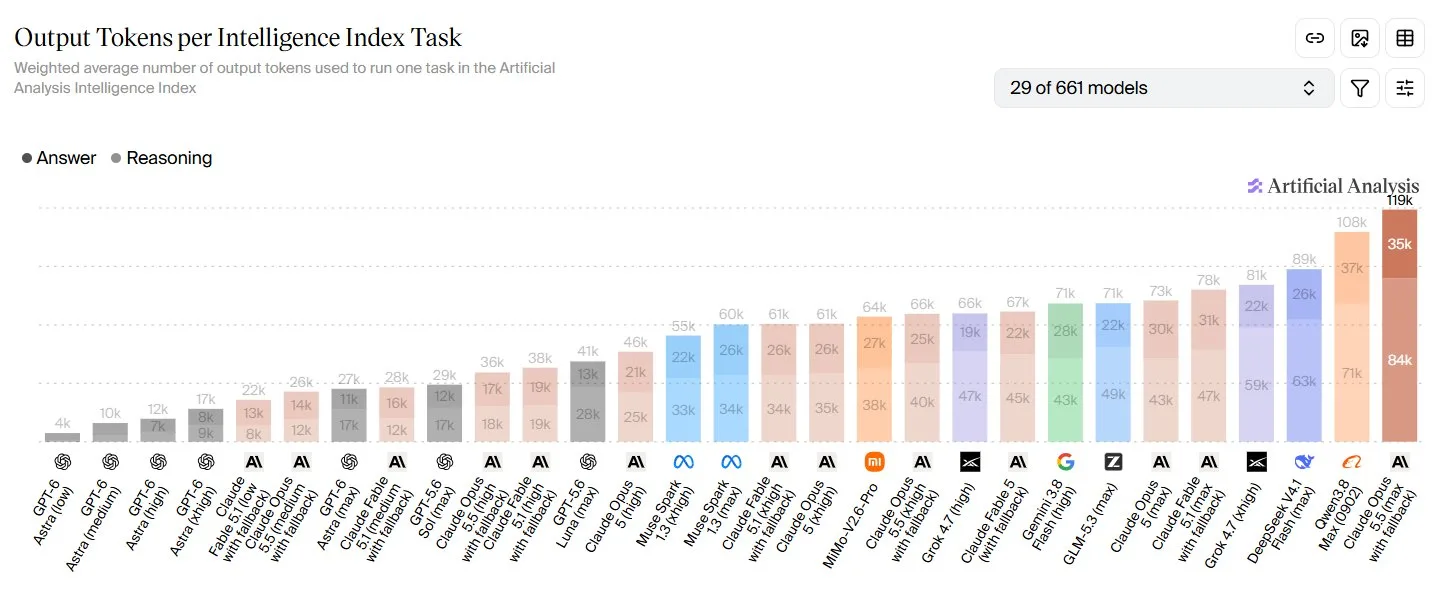
Claude Opus 5.5 の
- medium:1タスクあたり約26,000トークン
- high:約36,000トークン
- xhigh:約66,000トークン
- max:約119,000トークン
medium と
そして
な
実務では、
ここまでの
- 既定の
medium から 始める。 公式が 既定を high から medium へ 下げた こと 自体が、 推奨設定の 変更です。 medium の 57.7%と いう 水準は、 多くの 実務で 十分に 使えます - 上げるのは
難所だけに する。 大規模な 移行作業や、 原因の 見えない 不具合の 調査など、 難易度の 高い 場面だけ high や xhigh に 上げます。 会話の 途中で effort を 変える 機能 (ベータ)も あり、 プロンプトキャッシュを 保ったまま 切り 替えられます - max は
常用しない。 コストと トークンが 跳ね上がるわりに、 スコアが xhigh を 下回る 場合すら あります。max は 保険であって 既定値ではないと 考えてください - 自社の
課題で 一度だけ測る。 公式も 「自分の トラフィックの 一部で 2つか 3つの effort を 試し、 曲線から 答えを 読め」と 案内しています。 典型的な 作業を 3つほど 選び、 medium と high で 1回ずつ走らせて、 所要時間と コストと 結果を 記録してください
ひとつ前の
な
移行時に
コードを
- 思考を
無効に できない。 無効化の 指定は エラーに なります。 浅くしたい 場合は effort を 下げます - ツールの
強制呼び出しが 使えない。 tool_choice の any と tool は エラーに なります。 厳密な JSONが 必要なら、 strict な ツール利用か構造化出力に 移します - 思考ブロックが
モデルと 会話に 紐づく。 Opus 5 からの 引き継ぎは できますが、 Fable 系・Mythos 系との 間では 引き継げません - 旧い
コンピュータ操作ツールが 使えない。 computer_20251124 は Claude API と Google Cloud では 受け付けられません (Amazon Bedrock では 引き続き 動きます)
もう
よく
Claude Opus 5.5 とは
Claude Opus 5 から
effort は
ベンチマークの
料金は
参考文献
- Anthropic